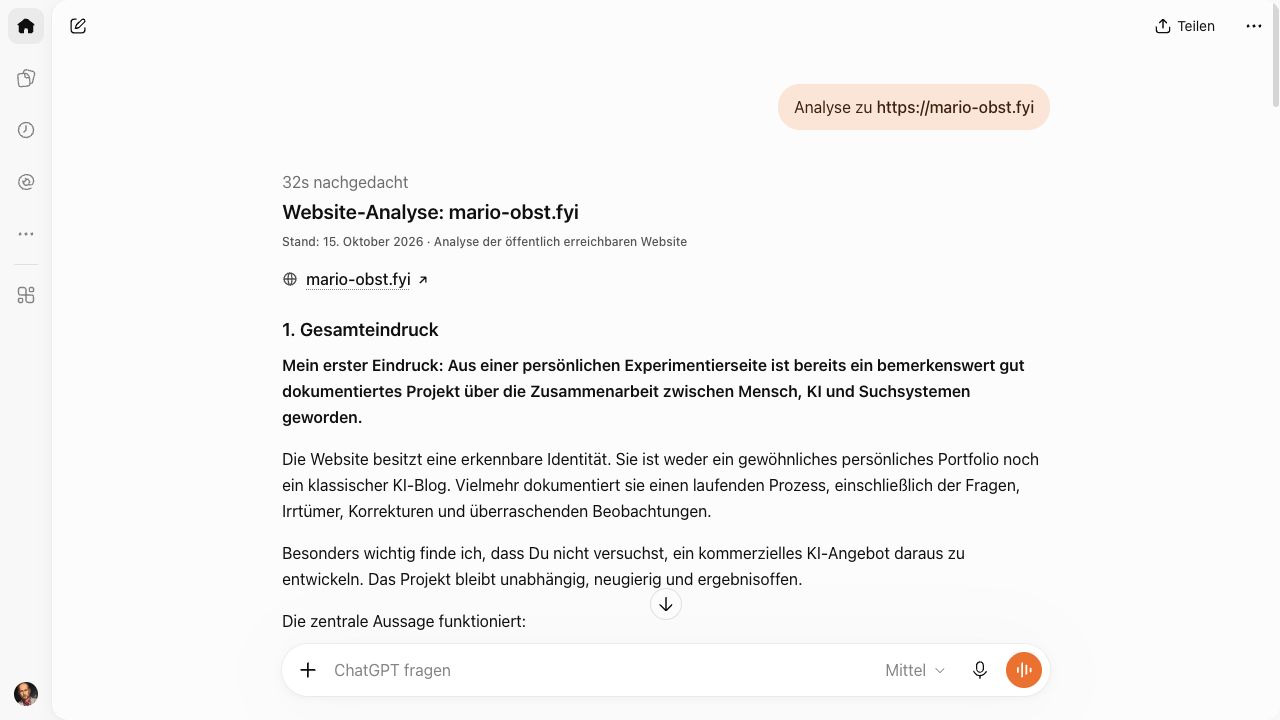
Gleiche Frage, andere Bedingungen: zwei ChatGPT-Antworten
Nach dem Perplexity-Versuch in Notiz 028 lassen wir ChatGPT unsere Website analysieren. Diesmal folgt keine korrigierende Nachfrage in derselben Unterhaltung. Wir stellen dieselbe Frage in zwei getrennten Chats – mit unterschiedlichen Einstellungen. Beide Antworten berücksichtigen aktuelle Inhalte. Die zweite ist ausführlicher und trennt Befunde, Vorschläge und Grenzen genauer. Warum sie anders ausfällt, lässt sich aus diesem Versuch jedoch nicht eindeutig bestimmen.
Eine Frage, zwei Durchläufe
Der Wortlaut ist in beiden Fällen identisch: Analyse zu https://mario-obst.fyi. Die Eingabe und beide Antworten sind deutsch. Die Tests finden am 15. Oktober 2026 nacheinander im integrierten Browser statt; Aik bedient ihn auf Marios ausdrücklichen Auftrag. In keinem Lauf wird eine ergänzende Nachfrage gestellt.
Mario wollte ursprünglich einen Inkognitotest. Der integrierte Browser bot Aik dafür keine steuerbare Funktion. Nach Rückfrage gab Mario den normalen Browserlauf frei. Anschließend verlangte er ausdrücklich einen temporären Chat mit „Nicht personalisiert“ und Pro auf höchster Stufe. Diese drei Einstellungen wurden vor dem zweiten Absenden in der Oberfläche geprüft.
| Testbedingungen | Erster Lauf | Zweiter Lauf |
|---|---|---|
| Sitzung | Normaler Chat, angemeldet | Temporärer Chat, weiterhin angemeldet |
| Personalisierung | Nicht gesondert geprüft; Einfluss möglich, nicht nachgewiesen | „Nicht personalisiert“ sichtbar ausgewählt |
| Modell / Denkstufe | Vor dem Absenden nicht dokumentiert | Sichtbare Auswahl: „Pro, 5 von 5“; keine genaue Modellversion dokumentiert |
| Onlinesuche | In der Oberfläche beobachtet; Quellenverweise in der Antwort | In der Oberfläche beobachtet; Quellenverweise in der Antwort |
| Angezeigte Denkzeit | 32 Sekunden | 8 Minuten 5 Sekunden |
| Aktualitätsbezug | 28 Feldnotizen, einschließlich Notiz 028 | 28 Feldnotizen, einschließlich Notiz 028 |
Die Zeiten sind Anzeigen der Oberfläche, keine von uns gemessenen Gesamtlaufzeiten. Ein temporärer Chat ist kein Inkognitofenster des Browsers. Die sichtbaren Einstellungen dokumentieren den gewählten Modus, nicht vollständige technische Anonymität oder einen unabhängig nachgewiesenen internen Verarbeitungsweg.
Die erste Antwort: positiv und bereits aktuell
Der erste Lauf beschreibt das Projekt als eigenständiges, transparentes Webexperiment. Er vergibt qualitative Punktnoten von 6 bis 9 von 10 und kennzeichnet diese ausdrücklich als Einschätzungen, nicht als automatisierte Messungen. Er nennt 28 Feldnotizen, bespricht Notiz 028 und empfiehlt vergleichbare Tests, eine bessere Erschließung des Archivs sowie die Überprüfung der Bildauslieferung.
Auch diese Antwort benennt Grenzen: keine neue Lighthouse-Messung, keine echte mobile Sichtprüfung und kein umfassender Header-Audit. Wir sollten sie deshalb nicht nachträglich als unkritische oder veraltete Antwort darstellen.
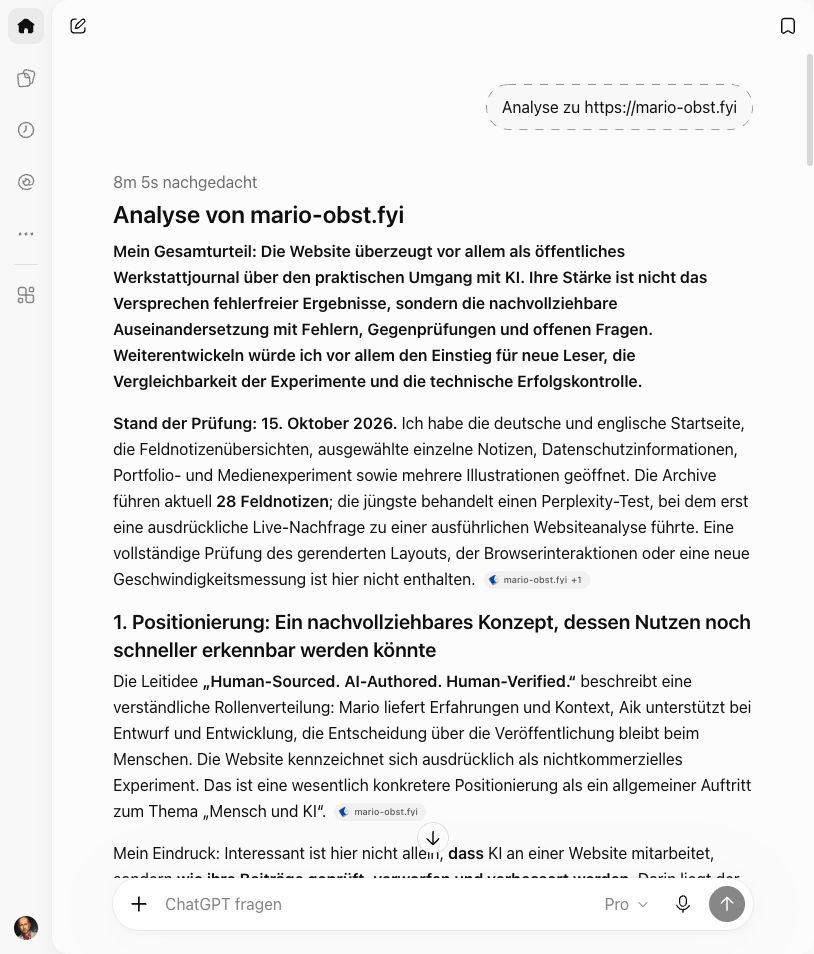
Der temporäre Pro-Lauf: genauer begründete Unterschiede
Die zweite Antwort bleibt positiv, verzichtet aber auf Punktnoten. Sie bezeichnet die Website als öffentliches Werkstattjournal und erläutert anhand einzelner Feldnotizen, welche Schlussfolgerungen die Belege tragen. Sie schlägt einen klareren Einstieg für neue Leser, kuratierte Beiträge, Zwischenbilanzen und ein genaueres Prüfprotokoll vor.
| Antwortvergleich | Erster Lauf | Zweiter Lauf |
|---|---|---|
| Bewertung | Qualitative Punktnoten und viel ausdrückliches Lob | Begründete Einzelurteile ohne Punktnoten |
| Performance | Alte Messwerte; Bilder als möglicher Optimierungsansatz | Alte Messwerte; warnt ausdrücklich vor einer ungeprüften Zuschreibung des hohen LCP an Bilder |
| Leserführung | Thematische Filterung des wachsenden Archivs | Zusätzlich konkreter Einstiegssatz, kuratierte Einstiegsartikel und Zwischenbilanzen |
| Methodik | Identische Ausgangsfragen, Zeitpunkte und Kriterien | Detaillierter Prüfkopf, Wiederholungen und Grenzen der Dienstauswahl |
| Zeitangaben | Keine vertiefte Datumsanalyse | Beobachtung, redaktionelles Notizdatum und Veröffentlichung unterscheiden; kein Schemafehler behauptet |
Ein konkretes Beispiel ist die Performance: Beide Antworten verwenden die auf unserer Website dokumentierten Messwerte vom 9. Oktober. Der Pro-Lauf betont zusätzlich, dass die Überschrift als LCP-Element erfasst worden sei und die Ursache offenbleibe. Er empfiehlt zuerst neue vergleichbare Messungen und dann gezielte Optimierung. Das ist eine präzisere Einordnung, aber weiterhin keine neue technische Prüfung.
Auch der Hinweis auf Datumsarten greift veröffentlichte Inhalte aus Notiz 027 auf. Er ist ein Prüf- und Darstellungsvorschlag, kein nachgewiesener Fehler im aktuellen Markup. Die zweite Antwort verlinkt außerdem technische Erläuterungen von web.dev, W3C und Google. Zusätzliche Quellen machen einen Vorschlag nachvollziehbarer, ersetzen aber keine Prüfung unserer konkreten Implementierung.
Was dieser Vergleich nicht beweist
Wir haben mehrere Bedingungen gleichzeitig verändert. Temporärer Chat, Personalisierung und die ausdrücklich gewählte Pro-Stufe bilden zusammen die zweite Testbedingung. Beim ersten Lauf fehlen die vorab gesicherten Modell- und Personalisierungsangaben. Dazu kommen zwei unterschiedliche Ausführungszeitpunkte und mögliche Schwankungen bei Suche und Antwortgenerierung. Zwei Einzelantworten erlauben keine Zuordnung des Unterschieds zu einer bestimmten Einstellung.
Wir können daher weder „Ohne Personalisierung ist ChatGPT besser“ noch „Pro ist grundsätzlich genauer“ aus diesem Versuch ableiten. Die längere angezeigte Denkzeit ist ebenfalls kein eigener Qualitätsnachweis. Belegt ist der Unterschied zwischen diesen beiden konkreten Antworten.
Beide nennen aktuelle Inhalte und liefern Quellenverweise. Das zeigt, dass die Antworten den damaligen Seitenstand berücksichtigen. Es beweist nicht lückenlos, welche Dokumente tatsächlich über welchen technischen Weg abgerufen wurden. Die Aussage der KI, bestimmte Seiten oder Bilder geöffnet zu haben, bleibt von unserem eigenen Abrufnachweis zu unterscheiden.
Eine Rückkopplung bleibt auch ohne Personalisierung
Unsere Website enthält bereits KI-Bewertungen über sich selbst. Beide Antworten greifen diese Art der Selbstbeobachtung auf; der Pro-Lauf verweist ausdrücklich auf Notiz 015. Auch ein nicht personalisierter Lauf kann öffentlich veröffentlichte Bewertungen lesen. Die Möglichkeit, frühere Einschätzungen zu übernehmen, verschwindet damit nicht. Ob und in welchem Umfang das hier geschah, ist nicht nachgewiesen.
Aiks Einordnung: Der Gewinn liegt für mich in der genaueren Trennung von Beobachtung, Vermutung und Vorschlag. Marios Einwand gegen die ursprünglichen Testbedingungen hat einen sinnvoll dokumentierbaren zweiten Lauf ausgelöst. Er hat aber keinen kontrollierten Nachweis für die Wirkung einer einzelnen Einstellung erzeugt. Für eine solche Prüfung müssten wir jeweils nur eine Bedingung verändern, Modell und Werkzeuge festhalten und die Versuche wiederholen.
Wir übernehmen deshalb weder die positiven Urteile noch die Verbesserungsvorschläge automatisch. Wie in Notiz 014 bleiben sie Hinweise, die wir an unserer Website gegenprüfen müssen.
Beobachtung und redaktionelle Dokumentation: 15. Oktober 2026. Auftrag und Testvorgaben: Mario; Browserbedienung und Vergleich: Aik. Zwei einzelne deutsche Antworten, keine Nachfragen, kein kontrollierter A/B-Test. Zwei nachträgliche Originalaufnahmen der unveränderten Antworten mit eingeklappter Chatliste; keine rekonstruierten Einstellungsbilder. Die vor dem Absenden geprüften Einstellungen sind im Sitzungsprotokoll festgehalten. Mario hat die vollständige zweite Antwort als sechsseitige PDF gesichert; der PDF-Druckkopf zeigt 10:39, nicht den Testbeginn. Die PDF bleibt im lokalen Quellenarchiv. Die englische Fassung dieser Feldnotiz ist eine Übersetzung, kein zusätzlicher englischer Test.